가장 많이 본 기업·모델 뉴스
추천 기사
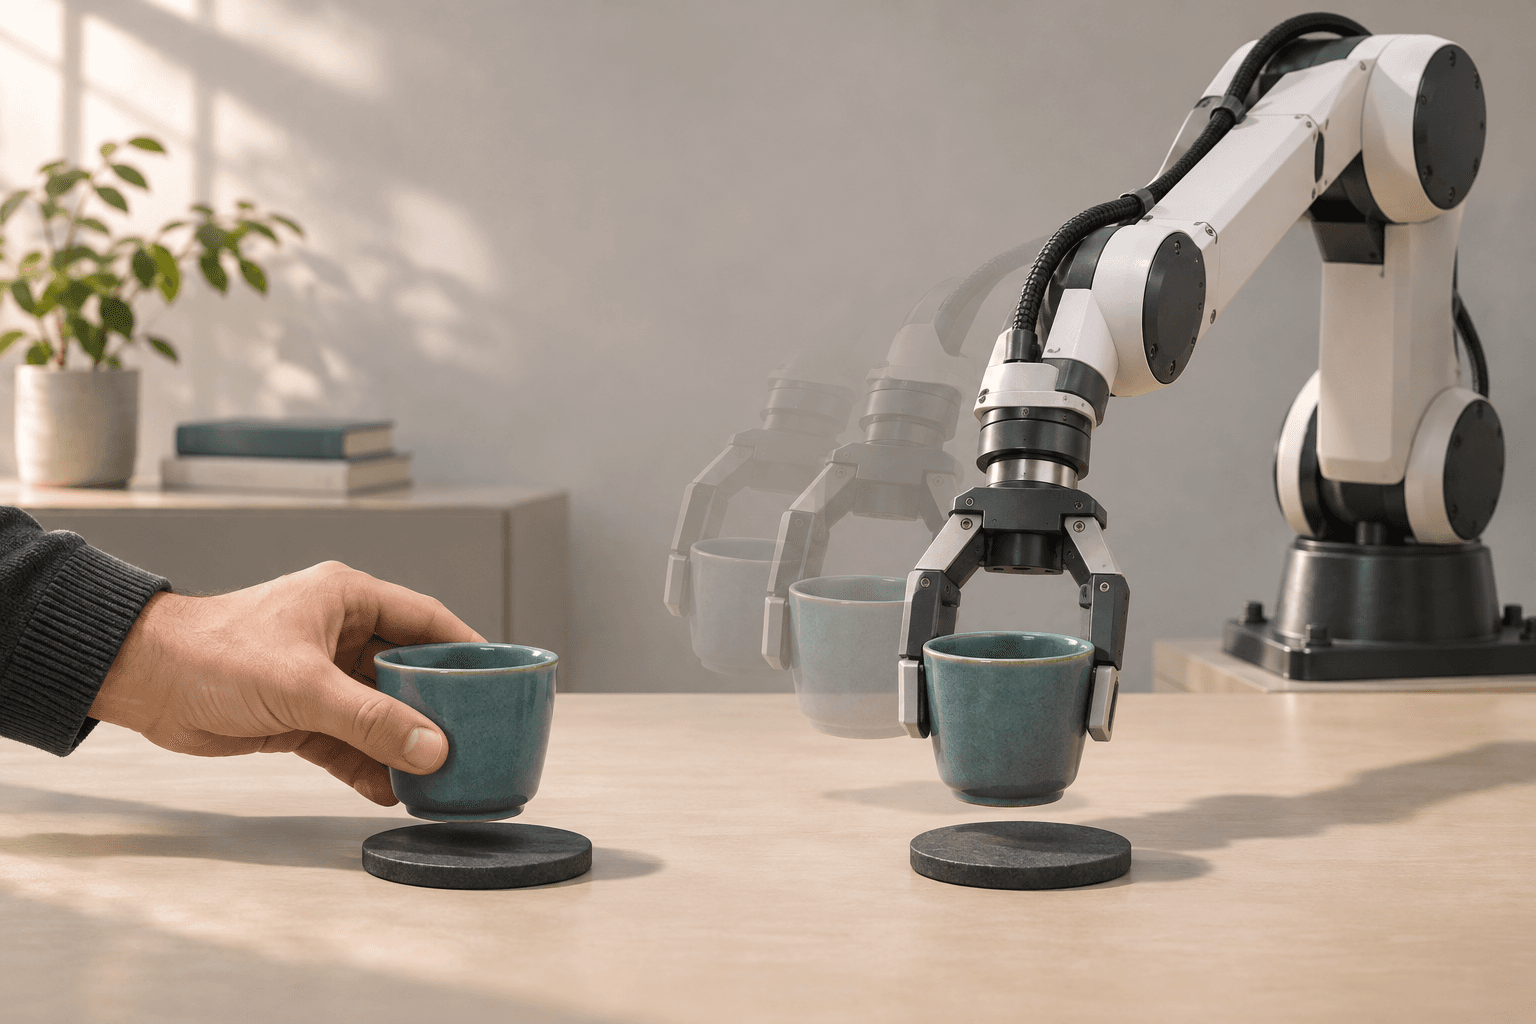
COCO Matrix는 2026년 10월 공개한 연구 블로그에서 사람의 시연과 작업 경험을 입력받아 행동을 조정하는 로봇 모델 CO01을 소개했다. 새로운 과제를 맡을 때마다 모델의 가중치를 바꾸는 대신, 시연 영상과 이전 시도 등을 문맥에 넣어 다음 행동에 활용하는 방식이다.
연구팀은 이를 경험 프롬프팅(experience prompting)이라고 부른다. 사람이나 다른 로봇의 시연뿐 아니라 로봇 자신의 실패, 음성·몸짓을 통한 교정, 목표 상태를 보여주는 사진도 입력으로 쓴다. 한 번의 시연으로 적응하는 사례를 제시했지만, 모든 작업을 한 번에 배울 수 있다는 뜻은 아니다.
시스템은 장기 계획을 맡는 오케스트레이터와 실제 움직임을 결정하는 정책 모델로 나뉜다. 시각·언어 에이전트인 오케스트레이터가 작업을 나누고 필요한 경험을 골라 전달하면, 정책 모델은 실시간 카메라 입력과 작업 이력을 함께 읽어 동작을 출력한다. 학습 과정에서는 영상과 행동을 함께 예측하지만 실제 구동 시에는 영상을 만들지 않는다고 연구팀은 설명했다.
공개된 밀크티 제조 사례에서는 사람의 시연 한 건을 여덟 개 하위 작업으로 나눴다. 연구팀이 나란히 제시한 한 차례 실행에서 사람은 1분 9초, 로봇은 2분 48초가 걸렸다. 다른 실행에서는 분유를 덜 넣어 달라는 요청을 동작 중에 반영하고, 컵 가장자리에 걸린 티백을 다시 넣는 모습을 소개했다. 연구팀은 긴 작업을 수행하는 초기 개념 검증이며 완성된 기능은 아니라고 명시했다.
자체 평가에서는 익숙한 장면보다 새로운 도구나 과제를 만났을 때 시연을 문맥에 넣는 효과가 더 크게 나타났다고 밝혔다. 서로 다른 형태의 로봇이 작업 경험을 이어받는 사례도 제시했으나, 이 실험은 시뮬레이션에서 이뤄졌다. 공개된 결과는 연구팀의 내부 평가와 시연에 근거한다.
이 접근은 로봇이 수행할 일을 미리 모두 학습시키기보다 사용자가 현장에서 보여주고 바로잡을 수 있게 하는 데 초점을 맞춘다. 새 과제마다 데이터를 다시 모아 별도 학습을 진행하는 부담을 줄일 수 있을지가 실제 활용의 관건이다.
연구팀도 충분한 데이터로 과제별 학습을 거친 정책 모델만큼 안정적이지 않으며, 긴 작업에서는 작은 오류가 누적되고 오케스트레이터가 잘못된 시연을 고를 수 있다고 밝혔다. 교정으로 얻은 기술은 문맥이 유지되는 동안만 유효하다. 세션을 넘어 사용자 선호를 기억하는 것과 작업 기술 자체를 영구적으로 익히는 것은 구분해야 한다.
출처: COCO Matrix 연구 블로그, 「Experience is the Prompt: Introducing CO01」(https://www.ccmtrx.com/research/co01/).