가장 많이 본 기업·모델 뉴스
추천 기사
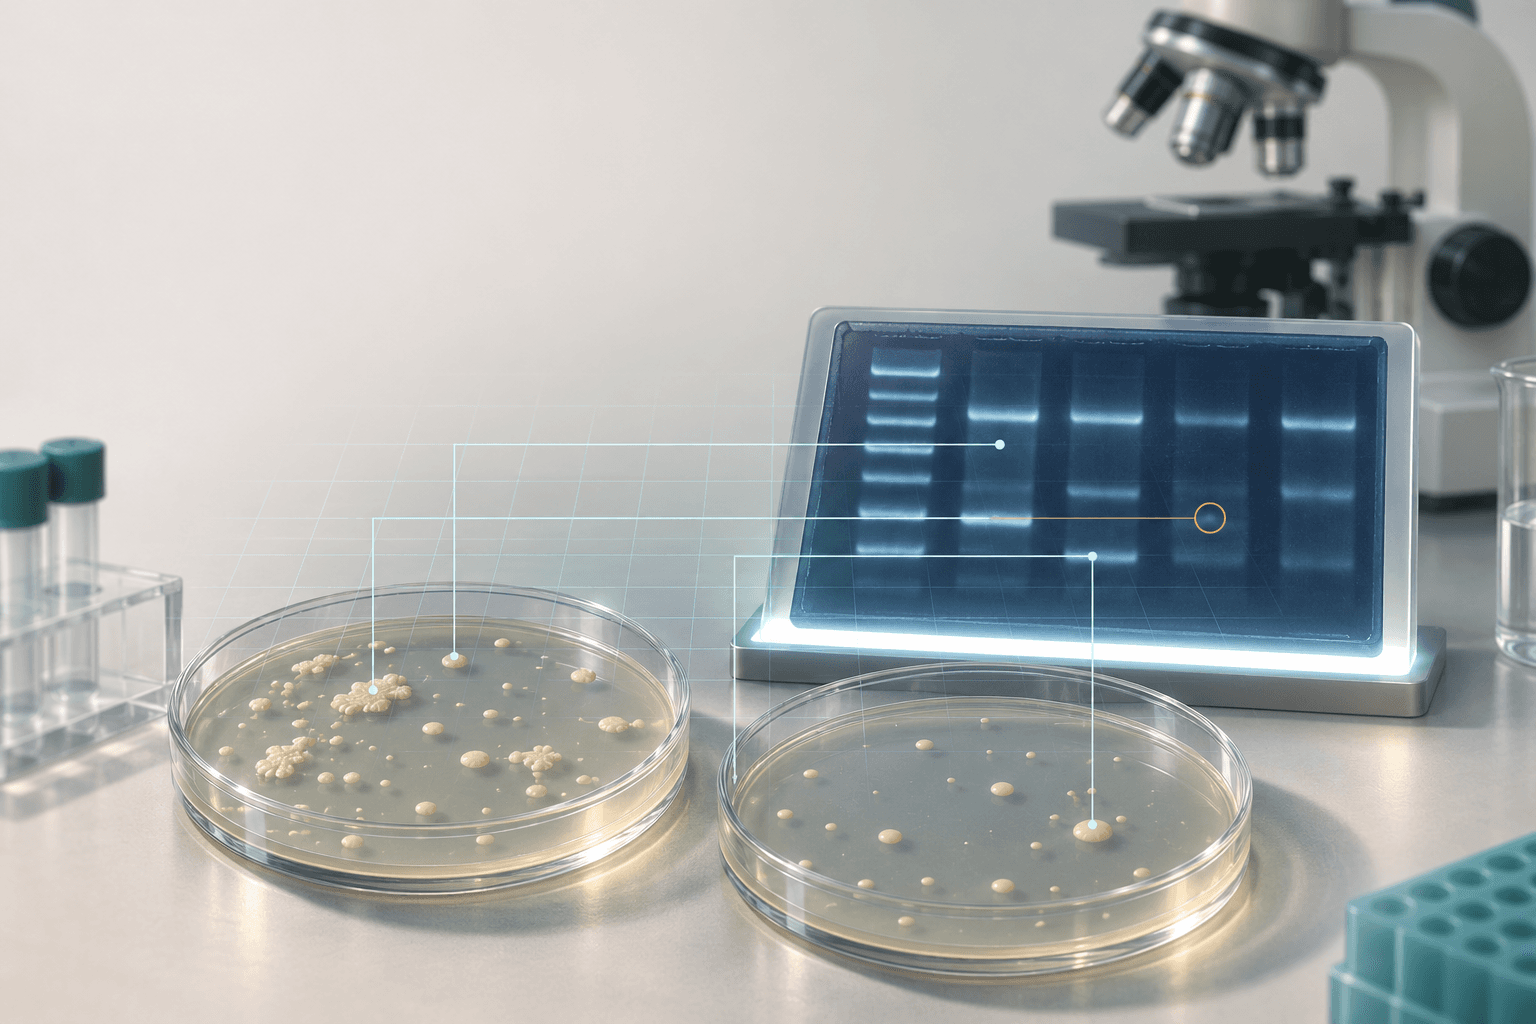
OpenAI가 바이오기업 Ligo와 함께 생물학 실험실의 일상적인 분석 능력을 측정하는 AI 평가 도구 ‘BioBasicsBench’를 공개했다. OpenAI 공식 연구 글에 따르면 이 평가는 정리된 논문 도표가 아니라 실험 현장에서 얻은 원자료를 읽고, 오류를 찾아내며, 근거가 부족한 상황을 구분하는 데 초점을 맞췄다.
실험실에서는 흐릿한 이미지나 서로 맞지 않는 관측 결과를 다뤄야 한다. 논문에 실릴 만큼 선별된 자료만으로는 이런 모호함과 문제 해결 능력을 충분히 평가하기 어렵다는 것이 개발 배경이다. 잘못된 이미지 해석이나 대조군 점검 누락이 이후 실험의 방향을 틀어놓을 수 있다는 문제의식도 담았다.
과제는 단백질 분석, 이미징·유세포 분석, 정량·분석 실험, 핵산 분석, 분자 클로닝 등 다섯 분야의 100개로 구성됐다. 젤·블롯 이미지와 배양 접시 사진뿐 아니라 현미경 영상, 염기서열 파일, 측정기 출력, 실험 영상 등을 사용한다. 과학자들이 자신의 실험 자료를 토대로 문제와 채점 기준을 만들었으며, 작성자가 아닌 Ligo 연구자의 내부 검토와 박사급 실험 연구자의 외부 검토, 최종 내부 검토를 거쳤다.
OpenAI는 7개 모델과 추론 강도를 조합한 37개 설정을 평가했다. 설정마다 100개 과제를 다섯 번씩 풀게 해 총 1만8500개의 결과를 얻었다. 모든 모델에 공통으로 보고한 xhigh 추론 설정에서 GPT-6 Astra의 평균 점수는 66.7%, GPT-6.1 Sol은 62.0%, GPT-5.6 Sol은 43.8%였다.
이 수치는 100개 문제 가운데 몇 개를 완전히 맞혔는지를 뜻하는 정답률이 아니다. 결론과 수치, 추론 과정, 근거 부족의 인식 등 과제별 기준에 따라 받은 부분점수를 합산한 평균이다. GPT-6 Astra의 95% 신뢰구간은 60.3~73.1%로 제시됐다. 평가 대상도 OpenAI 모델 7종으로 한정돼 다른 기업 모델과의 비교 결과로 볼 수는 없다.
개선 사례로는 실험 대조군의 항생제 표기가 실험 조건과 다르다는 점을 찾아낸 경우가 소개됐다. GPT-5.6 Sol은 대조군 접시에 집락이 없다는 관찰을 토대로 결론을 냈지만, GPT-6 Astra는 표기된 항생제가 달라 신뢰할 수 있는 대조군이 아니라고 판단했다. 현미경 영상에서 세포가 보였다 사라지는 현상을 생물학적 변화가 아닌 촬영 깊이의 변화로 해석한 사례도 있었다.
그러나 오류는 여전히 남았다. GPT-6 Astra가 대조군보다 익숙한 가정을 앞세워 잘못된 집락을 선택하거나, 자신의 해석과 어긋나는 관측을 최종 결론에서 제외한 사례가 보고됐다. 일상적인 집락 수 세기에서도 기준값보다 약 12% 많이 센 예가 제시됐다.
OpenAI는 높은 벤치마크 점수가 곧 실험실에서 신뢰할 만한 판단을 내릴 수 있다는 뜻은 아니라고 선을 그었다. 회사는 원자료 해석과 대조군 확인, 근거가 뒷받침하지 않는 결론을 피하는 능력을 개선 목표로 제시했다. 이번 결과는 실험실 분석 보조의 진전과 함께, 점수만으로는 가려지기 쉬운 판단 오류를 보여준다.
출처: OpenAI 공식 연구 글 ‘Measuring how AI agents handle everyday wet-lab science’ https://openai.com/index/measuring-how-ai-agents-handle-wet-lab-science/