가장 많이 본 기업·모델 뉴스
추천 기사
독립 연구자 Josef Chen이 로봇의 작업 성공 여부를 영상으로 판별하는 시각언어 모델 ‘RoboJev-27B’를 공개했다. 연구자 홈페이지와 허깅페이스 모델 저장소에는 가중치, 추론 코드, 평가자료와 재현 패키지가 올라왔다. 공개 평가 요약의 릴리스 날짜는 10월 23일이다.
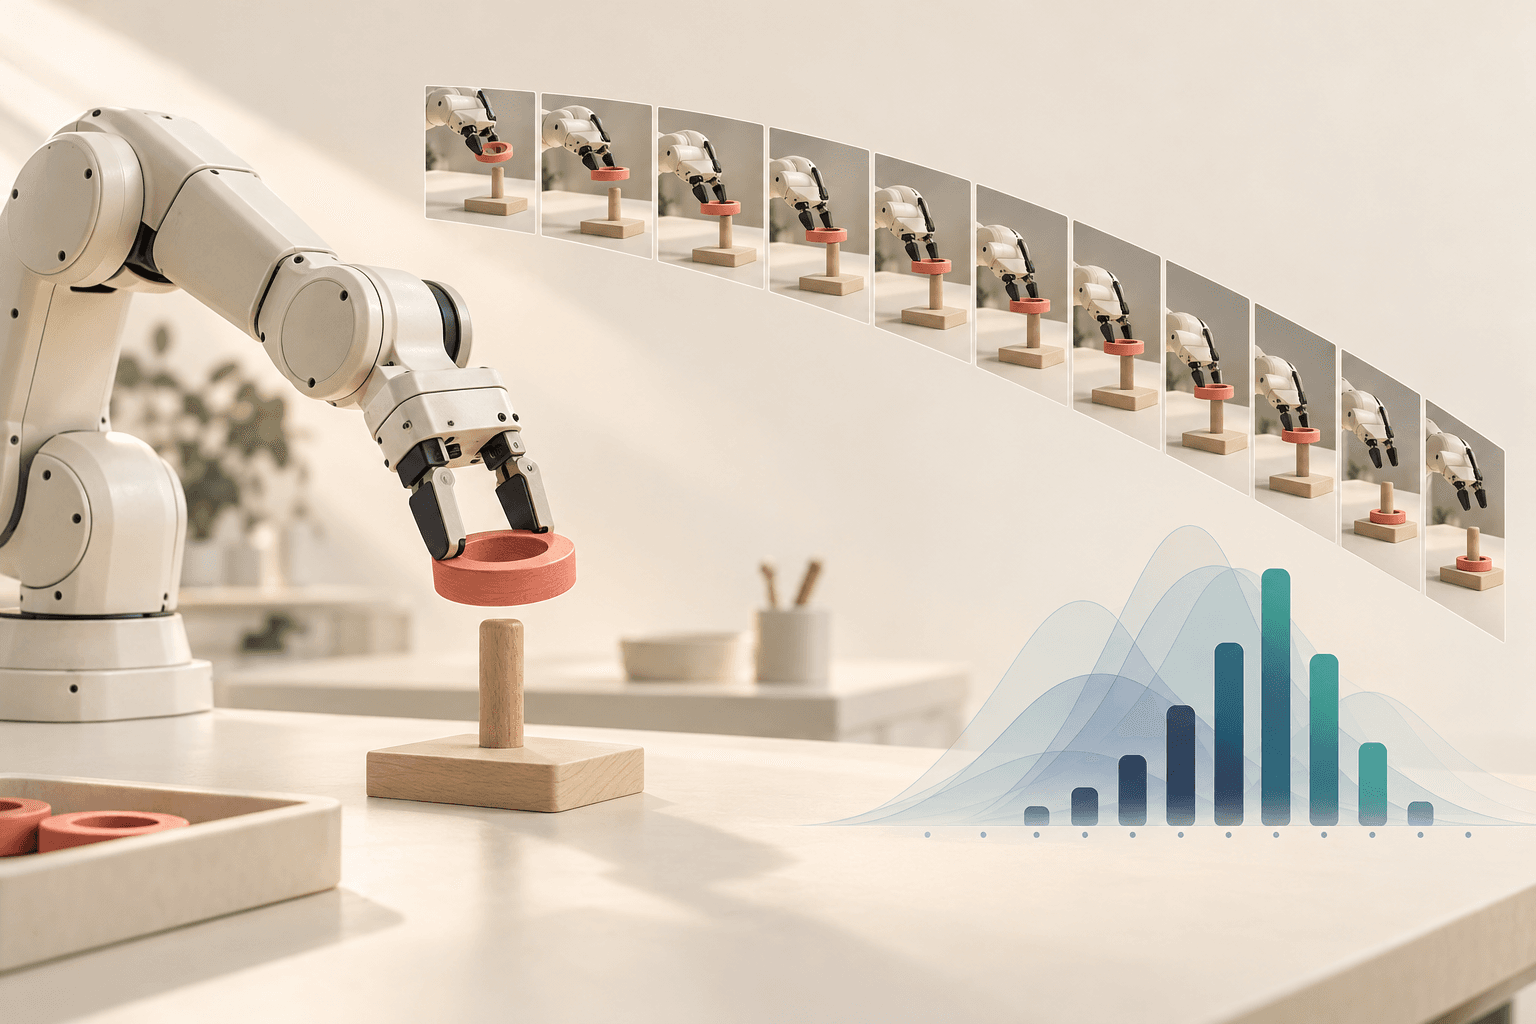
RoboJev는 로봇을 직접 움직이는 제어 모델이 아니다. 작업 지시문과 수행 영상에서 일정한 간격으로 추출한 주 카메라 이미지 10장을 읽고, 다른 카메라가 있으면 마지막 장면도 함께 받아 작업이 끝났을 확률을 산출한다. 긴 설명을 작성하는 대신 성공·실패에 해당하는 두 토큰의 점수를 한 번의 추론으로 계산한다.
기반 모델은 JEV-27B-VL이다. 연구자는 시각 인코더를 고정하고 언어 모델 부분에 LoRA 미세조정을 적용했다. 학습에 사용한 자료는 로봇 수행 기록 5만2598건으로, 서로 다른 실제 시도가 중복 없이 집계된 수치는 아니라고 명시했다.
연구자가 보고한 SO-101 로봇 평가 268회에서 균형 정확도는 95.2%였다. 균형 정확도는 성공 사례와 실패 사례를 각각 맞힌 비율의 평균이다. 다만 이 평가에는 학습자료와 같은 환경에서 촬영 세션을 나눈 기록이 포함돼 있다. 과제 전체를 학습에서 제외한 평가는 268회 가운데 80회로, 모든 결과를 새로운 과제에 대한 성능으로 볼 수는 없다.
학습에 포함되지 않은 실험실·로봇 환경 기록 459회에서는 결과가 달랐다. 성공과 실패를 구분하는 능력을 나타내는 AUROC가 RoboJev는 0.890, 같은 영상 입력을 받은 기본 JEV 모델은 0.900이었다. 연구자도 미세조정이 낯선 환경 전반의 성능 향상으로 이어졌다고 결론 내리지는 않았다.
범용 AI 모델과의 비교 역시 조건을 살펴야 한다. 비교 대상 API 모델에는 주 카메라 이미지 4장만 제공한 반면 RoboJev에는 10장과 추가 시점 이미지를 입력했다. SO-101 평가에서 GPT-6 Astra와의 균형 정확도 차이에 대한 95% 신뢰구간도 0을 포함해, 이 결과만으로 우위를 확정하기 어렵다.
단일 H100 GPU에서 순차 실행한 추론 시간의 중앙값은 수행 기록당 약 0.26초로 제시됐다. 모델 가중치는 bf16 형식으로 약 54.7GB이며, 연구자는 메모리 80GB GPU 한 대를 실행 환경으로 안내한다. 이 추론 시간은 영상 다운로드·디코딩이나 서비스 대기시간을 포함한 전체 처리시간과 구분해야 한다.
공개 도구에는 파이썬 클라이언트, 데이터셋 일괄 채점기, 영상에 성공 확률을 표시하는 기능과 LeRobot 연동 플러그인이 포함됐다. 로봇 수행 기록을 검토하거나 학습용 보상 신호를 연구하는 데 활용할 수 있지만, 이 도구를 적용해 로봇 정책의 학습 성능이 개선됐다는 실험 결과는 아직 제시되지 않았다.
논문은 학술지·학회에 제출되지 않은 원고이며 arXiv 식별자나 DOI도 없다. 연구자는 개발 과정에서 평가자료를 살펴봤고, 일부 커뮤니티 영상에는 한 명의 평가자가 정답을 부여했다는 한계도 공개했다. 출력은 모델의 추정치로, 실제 로봇의 안전을 보장하거나 안전 제어기를 대신하는 용도가 아니다.
출처: Josef Chen 연구 원고, “RoboJev: An Open Vision-Language Judge for Robot Success Detection”
https://robo-jev.com/paper/RoboJev.pdf
연구자 공식 허깅페이스 모델카드
https://huggingface.co/josefchen/RoboJev-27B
RoboJev 공식 평가자료
https://robo-jev.com/data