가장 많이 본 기업·모델 뉴스
추천 기사
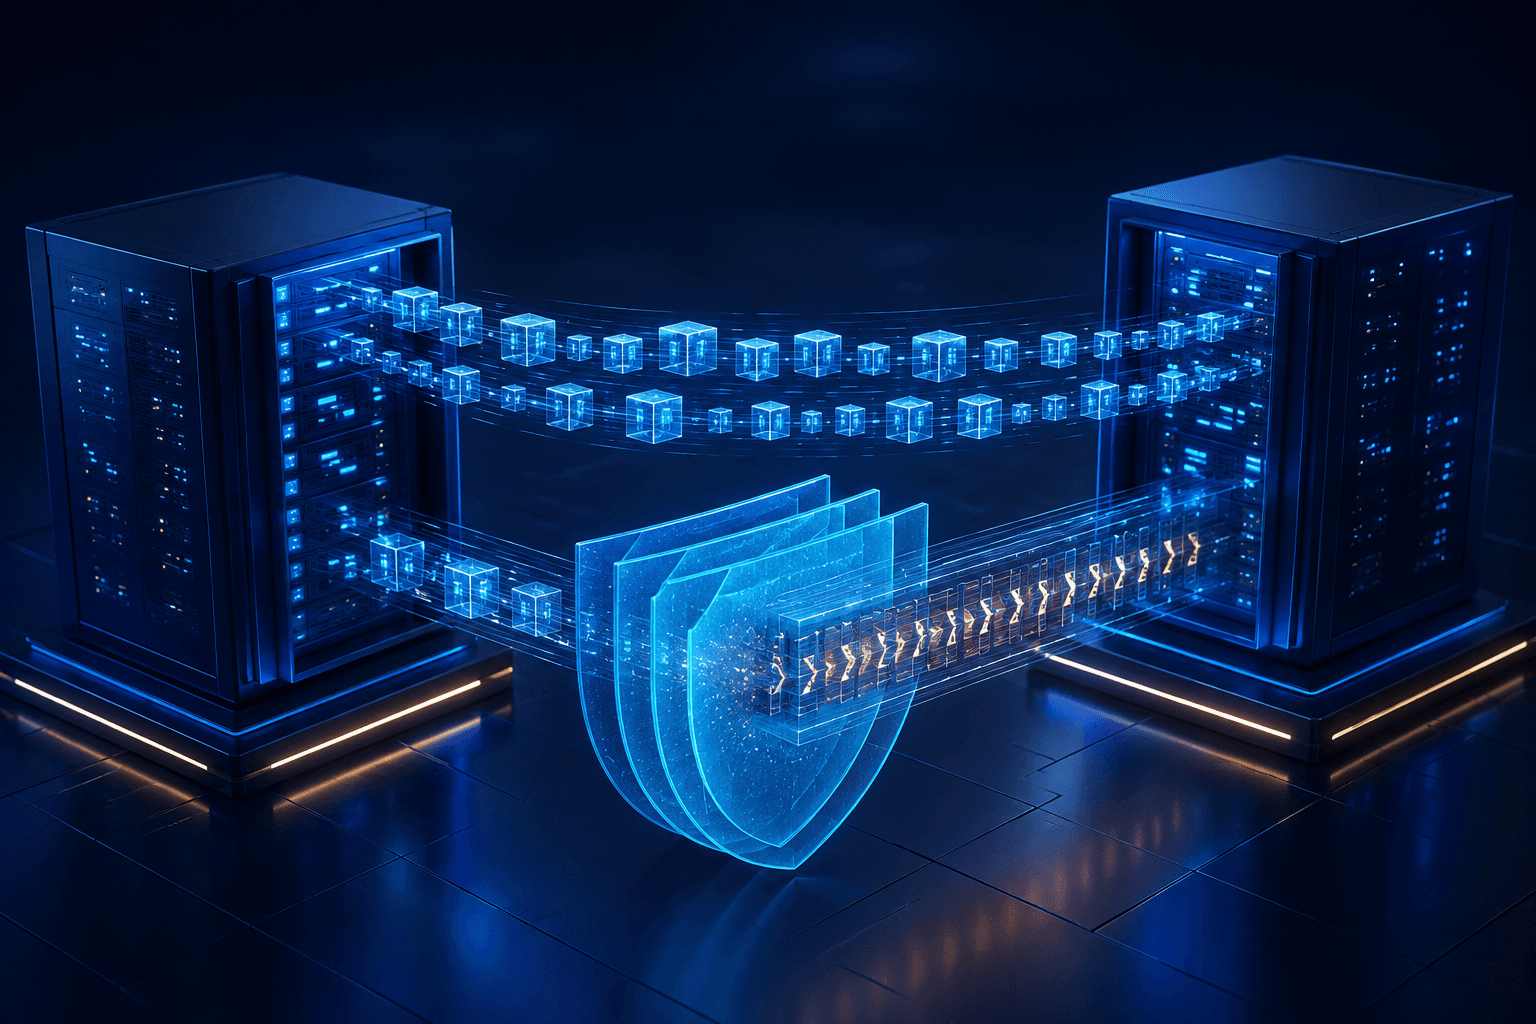
연구자 원문 사전공개 논문에 따르면, 분할형 대규모 언어모델(LLM) 학습에서 신뢰 구간으로 되돌아가는 출력 그래디언트가 실제 데이터와 위장 데이터를 구분하는 신호로 작용할 수 있는 것으로 나타났다. 연구진은 전방 채널만 검사한 프라이버시 평가로는 이 누출을 놓칠 수 있다고 지적했다.
분할 학습은 모델과 연산을 두 구간으로 나눠 민감한 원본 데이터를 직접 공유하지 않고 학습하는 방식이다. 논문이 분석한 두 노드 구성에서는 신뢰할 수 있는 로컬 노드가 보호된 활성값을 신뢰하지 않는 클라우드 노드로 보내고, 클라우드 노드가 계산 결과를 돌려보내면 로컬 노드가 손실을 계산한 뒤 출력 그래디언트를 다시 전송했다.
문제는 클라우드 노드가 받는 프레임에 실제 데이터 행과 위장 행이 함께 포함됐지만 손실 함수가 위장 행을 무시했다는 점이다. 이 때문에 위장 행의 그래디언트가 정확히 0이 됐고, 0이 아닌 행의 위치만 확인해도 어떤 행이 실제 데이터인지 드러났다.
연구진은 사전에 정한 측정 절차로 이 경로를 점검했다. 누출을 의도적으로 주입해 측정기가 이를 탐지하는지 확인하고, 라벨을 섞은 대조군으로 누출이 없을 때 오탐하지 않는지도 검사했다. 논문 초록에 따르면 9개 시드에서 매 실행마다 4,096개 프레임 모두 실제 행이 식별됐다. 프레임 내용을 겨냥한 공격은 고정 추측 기준선보다 100개당 약 1개의 토큰을 더 복원했으며, 향상 폭은 0.65~1.50%포인트였다. 라벨을 섞은 대조군에서는 추가 복원이 나타나지 않았다.
같은 현상은 모델 품질을 허용 범위에 유지한 별도 구성에서도 반복됐다. 두 데이터셋의 해당 실행은 전방 채널 프라이버시 검사와 품질 검사를 통과했지만, 반환 그래디언트까지 포함해 같은 검사를 수행하자 실패했다. 연구진은 각 행의 그래디언트를 클리핑하고 잡음을 더해 약 0.01나트의 검증 교차엔트로피 비용으로 관찰된 누출을 막았다고 보고했다.
다만 이번 결과는 특정 두 노드 시스템과 평가 구성에 대한 사례 연구다. 연구진도 여러 학습 단계의 관측을 누적하는 공격 등 다섯 종류의 공격을 측정하지 않았다고 명시했다. 따라서 제안한 완화책이 분할 LLM 학습 전반의 안전을 보장한다는 의미는 아니며, 반환 경로를 포함한 전체 프로토콜 단위 검증이 필요하다는 결론이다.
출처: Georgios Politis·Evangelos Pappas, “Privacy Failure in Split-LLM Training, The Returned Gradient Nullifies the Decoys” (arXiv, 2026년 9월 3일) https://arxiv.org/abs/2609.04382