가장 많이 본 오픈소스 뉴스
추천 기사
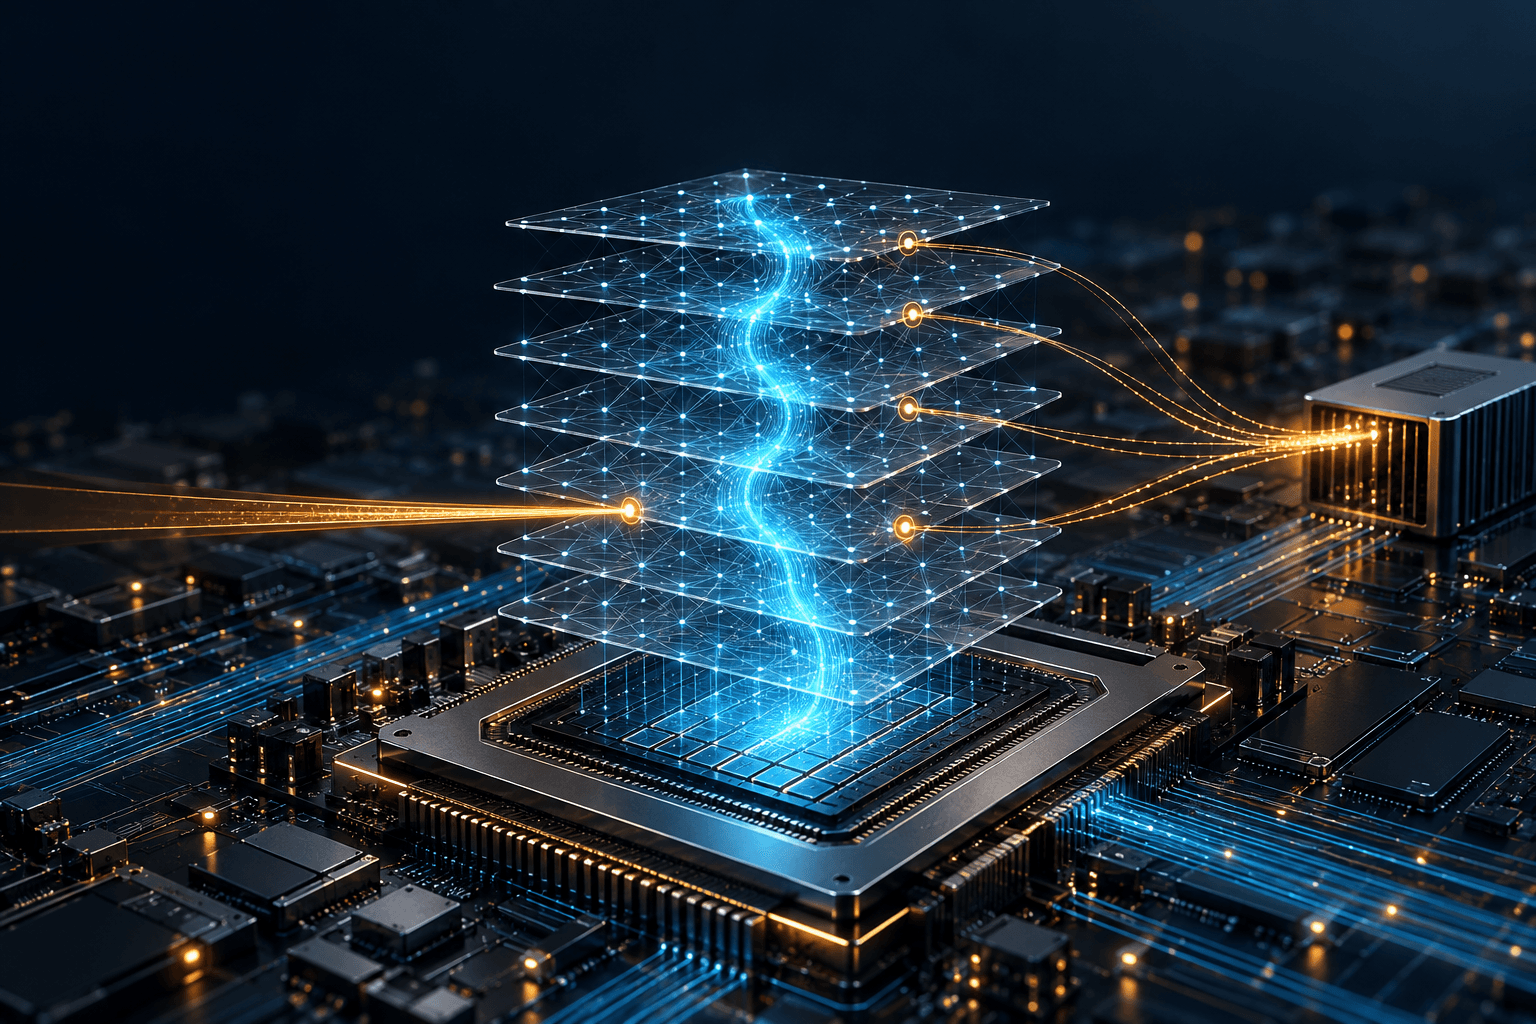
IBM이 대규모언어모델의 내부 상태를 관찰하고 출력 방향을 조정하는 도구 vLLM-Hook MIA를 소개했다. 추론 엔진 vLLM의 CUDA 그래프 실행을 유지하면서 요청별로 서로 다른 내부 데이터를 읽거나 수정하는 것이 핵심이다.
IBM은 21일 공식 연구 블로그를 통해 MIA(Model Internals Aperture)의 구조와 실험 결과를 공개했다. 공개 저장소와 연구진 기술 보고서에 따르면, 모델 가중치를 다시 학습하거나 vLLM 엔진을 별도로 수정한 복사본을 운영하지 않고 플러그인으로 기능을 붙이는 방식이다.
기존 내부 분석 도구 가운데는 모델의 각 층에서 파이썬 코드를 실행하기 위해 CUDA 그래프 재실행을 꺼야 하는 경우가 있다. CUDA 그래프는 반복되는 GPU 연산을 묶어 재실행해 CPU의 개별 연산 호출 부담을 줄이는 기능이다. 이를 비활성화하면 내부 상태에 접근하기는 쉬워지지만 추론 지연이 커질 수 있다.
MIA는 그래프를 기록하기 전에 내부 데이터 수집과 제어용 연산을 넣고, 고정된 GPU 메모리 주소의 경로 정보만 실행 때마다 바꾼다. 스케줄러는 각 요청이 읽거나 수정할 층과 토큰을 해당 배치에 맞춰 지정한다. 쿠리어는 수집된 데이터를 비동기로 CPU 메모리 등에 옮겨 다음 추론과 데이터 전달이 겹쳐 진행되도록 한다.
연구진은 NVIDIA H100 80GB GPU와 vLLM 0.29.0을 사용한 실험에서 비용을 측정했다. 초당 1~16건의 요청을 보내 Llama-3.1-8B의 모든 층에서 숨은 상태를 수집했을 때, 기본 vLLM 대비 출력 토큰당 중앙 지연시간이 4.9~6.4% 늘었다고 보고했다. Qwen2.5-1.5B-Instruct의 모든 층에 제어 벡터를 적용한 실험에서는 증가 폭이 3.7~5.6%였다.
이 수치는 연구진이 정한 모델과 하드웨어, 요청 부하에서 얻은 결과다. 모든 서비스에서 같은 성능이 나온다는 뜻은 아니다. 또한 내부 상태에 접근하는 비용을 측정한 것으로, 악성 요청 차단이나 허위 답변 탐지의 정확도를 그 수치만으로 입증하지는 않는다.
공개 저장소는 Linux와 CUDA 13 드라이버를 갖춘 NVIDIA GPU를 요구하며, H100 80GB에서 검증했다고 안내한다. 파이프라인 병렬화는 지원하지 않는다. 안전성 검사와 답변 제어를 실제 서비스에 붙이려는 개발자에게는 추론 속도뿐 아니라 지원 구성과 데이터 수집에 필요한 GPU 메모리도 도입 판단 기준이 된다.
출처: IBM Research 공식 블로그 ‘Toward fast AI interpretability and control’ https://research.ibm.com/blog/fast-interpretability-plugin-vllm
IBM 공식 GitHub 저장소 vLLM-Hook MIA https://github.com/IBM/vLLM-Hook
연구진 기술 보고서 ‘MIA: Runtime-Reconfigurable Access to Model Internals in LLM Inference Engines’ https://github.com/IBM/vLLM-Hook/blob/main/docs/MIA_Arxiv_.pdf