가장 많이 본 오픈소스 뉴스
추천 기사
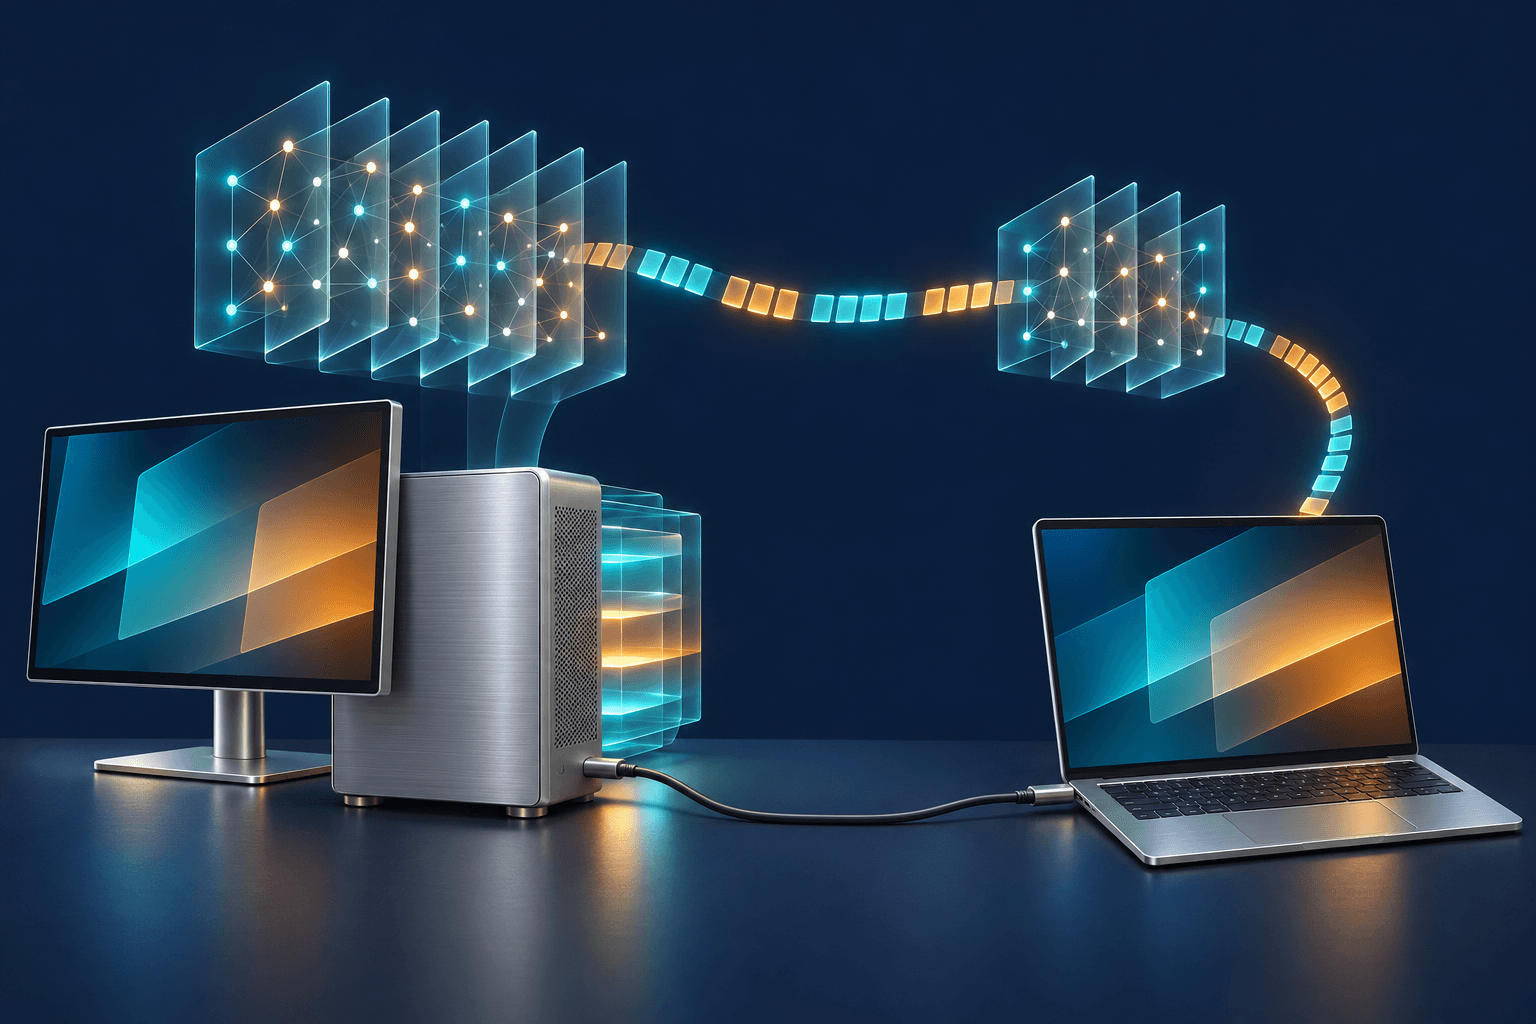
맥용 로컬 AI 추론 도구 oMLX가 두 대의 맥에 긴 입력문 처리 작업을 나누는 실험적 기능을 공개했다. oMLX 공식 GitHub 릴리스에 따르면 4일 공개한 0.7.4.dev1 개발 버전에 '프리필 가속기(Prefill Accelerator)'가 추가됐다. 큰 모델을 담을 메모리는 충분하지만 GPU 연산이 상대적으로 느린 맥에, 연산 성능이 더 높은 다른 맥을 연결하는 방식이다.
프리필은 모델이 답변 생성을 시작하기 전에 입력된 프롬프트를 처리하는 단계다. 이번 기능은 긴 프롬프트를 여러 조각으로 나눈 뒤 보조 맥이 신경망의 앞쪽 레이어를 계산하고, 모델을 실행하는 주 맥이 나머지를 처리하도록 한다. 답변 토큰을 차례로 만드는 디코딩과 KV 캐시, API는 주 맥에 그대로 남는다. 두 기기의 메모리를 합쳐 더 큰 모델을 실행하는 기능과는 구분된다.
프로젝트 측은 M3 Ultra 512GB에 M5 Max 128GB를 연결한 구성에서 처리량 개선을 측정했다고 밝혔다. 64K 토큰 길이의 프롬프트를 처리할 때 DeepSeek V4.1 Flash의 프리필 처리량은 초당 1060토큰에서 3123토큰으로, Qwen3.8 Flash-Next는 초당 1309토큰에서 3666토큰으로 늘었다. 각각 약 2.95배와 2.80배다. 공식 실험 문서의 연결 환경은 썬더볼트 5이며, 이 수치는 프로젝트 측 측정 결과다.
보조 기기의 메모리 용량에 따라 효과도 달랐다. 같은 릴리스에서 M5 Max 64GB를 연결했을 때 DeepSeek V4.1 Flash는 초당 1466토큰, Qwen3.8 Flash-Next는 2859토큰을 기록했다. 보조 맥에 적재할 수 있는 레이어가 적으면 분담하는 작업도 줄어든다는 설명이다. 디코딩 속도는 바뀌지 않으므로 프리필 처리량의 증가를 답변 전체 생성 속도의 같은 배수 향상으로 해석할 수는 없다.
연결에는 RDMA가 필요하지 않다. 공식 문서는 썬더볼트나 5GbE 이상 네트워크로 측정상의 최대 속도를 낼 수 있다고 안내한다. 2.5GbE에서도 가속 효과를 얻을 수 있지만 여유 대역폭은 줄고, 1GbE와 와이파이는 전송 속도가 병목이 될 수 있다. 양쪽 맥에는 같은 oMLX 버전이 필요하며 분산 추론과 로컬 네트워크 접근을 허용해야 한다. 보조 맥은 SSH 연결을 위해 원격 로그인을 켜야 한다.
현재 지원 대상은 DeepSeek V4.1, GLM-5.3 Flash, Qwen3.8 Flash-Next, MiniMax M3·M3.1 계열이다. 공식 문서에 따르면 2048토큰보다 짧은 프롬프트와 이미지가 포함된 프롬프트는 주 맥에서 처리한다. 보조 맥의 연결이 끊어지면 마지막으로 끝낸 조각 이후의 작업을 주 맥에서 이어간다.
수치 정밀도와 배포 단계에도 조건이 있다. 프로젝트는 DeepSeek V4.1과 Qwen3.8 측정에서 INT8 활성값 프리필을 사용했으며, 이 경로는 연산 수치에 차이를 만들 수 있다고 설명했다. 기능 문서의 상태는 '실험적'이다. 릴리스 안내 역시 안정 버전이 필요한 이용자에게 0.7.3 사용을 권고하고 있어, 이번 결과는 개발 버전의 특정 모델·하드웨어·입력 조건을 기준으로 봐야 한다.
출처: oMLX 공식 0.7.4.dev1 릴리스 https://github.com/jundot/omlx/releases/tag/v0.7.4.dev1 · oMLX 공식 프리필 가속기 문서 https://raw.githubusercontent.com/jundot/omlx/v0.7.4.dev1/docs/experimental/prefill-accelerator.md · GitHub 공식 릴리스 메타데이터 https://api.github.com/repos/jundot/omlx/releases/tags/v0.7.4.dev1