가장 많이 본 에이전트·코딩도구 뉴스
추천 기사
깃허브가 코딩 작업의 성격에 따라 AI 모델을 고르고 여러 모델의 실행을 조율하는 '코파일럿 퓨전(Copilot Fusion)'을 정식 출시했다. 28일 공개한 공식 변경 로그에 따르면 기존 프로젝트 하이드라퓨전의 다중 모델 조합 기술과 자동 모델 선택 기능을 통합했다.
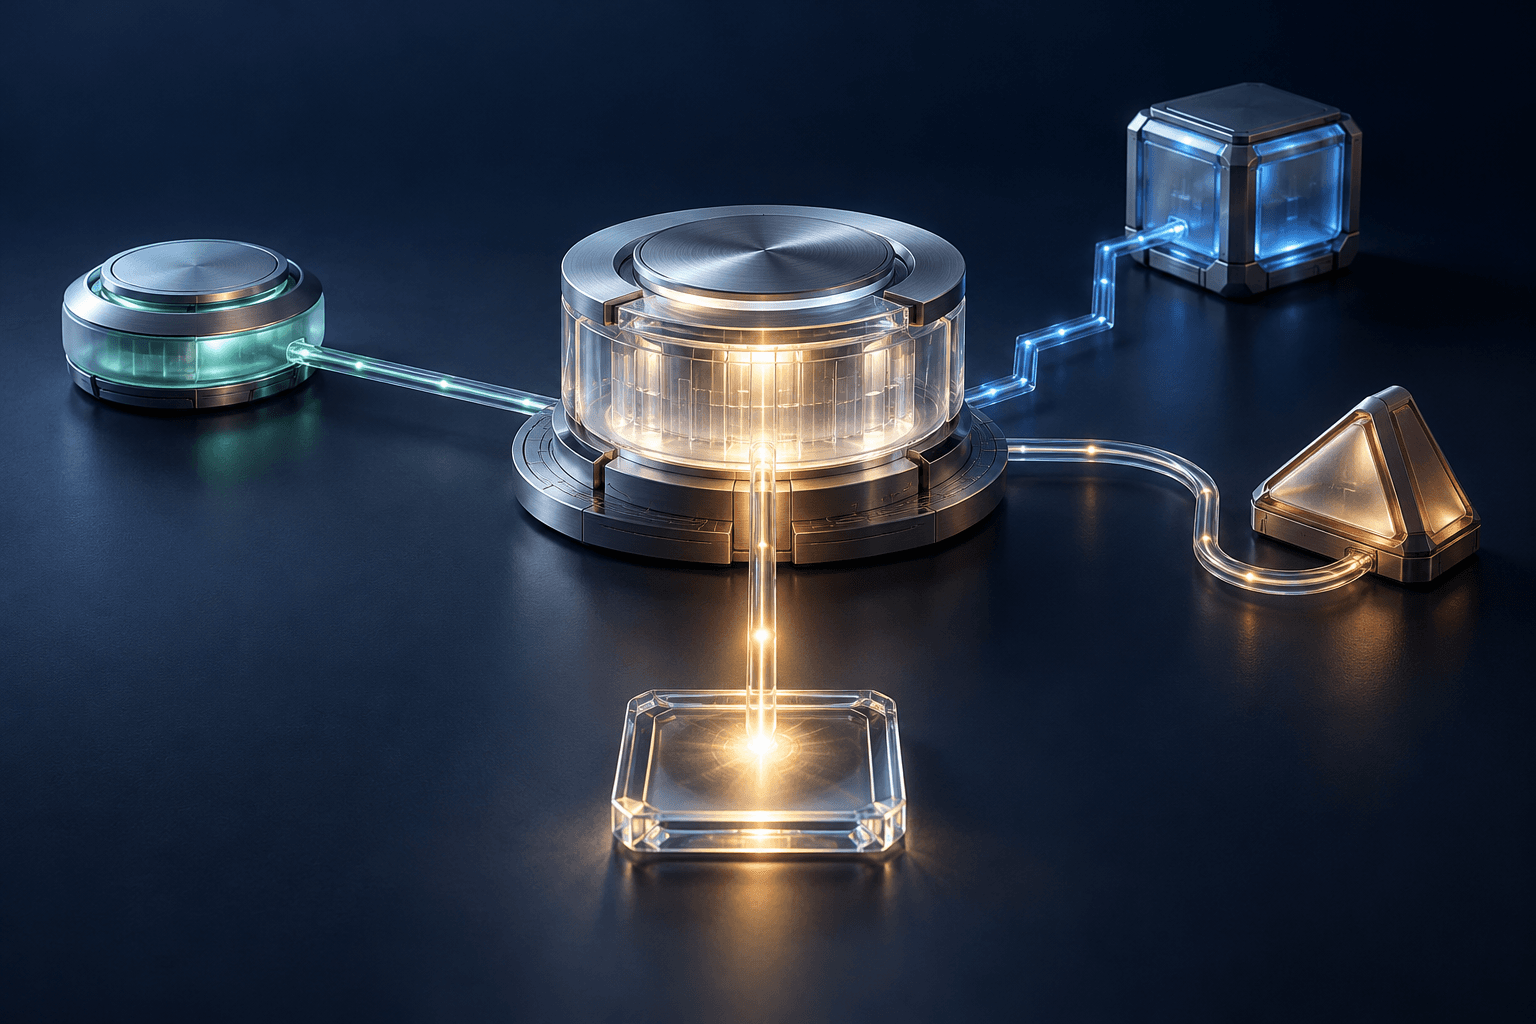
퓨전은 새 언어모델 하나를 제공하는 제품이 아니다. 사용자가 모델 선택 메뉴에서 퓨전을 고르면, 시스템이 각 요청에 사용할 모델과 처리 방식을 결정한다. 개발자가 작업 중간마다 모델을 바꿔 가며 초안 작성과 검토를 따로 지시하는 부담을 줄이는 구조다.
실행 방식은 세 가지다. '싱글'은 한 모델이 작업을 끝낸다. '캐스케이드'는 효율적인 모델이 먼저 초안을 만들고, 품질 검사 결과에 따라 그대로 채택하거나 더 강한 모델에 맡긴다. '크리틱'은 초안을 다른 모델이 검토한 뒤 원래 모델이 수정하는 방식이다. 공식 문서는 여러 검토 모델이 병렬로 의견을 낼 수 있으며, 같은 대화에서도 요청마다 실행 방식이 달라질 수 있다고 설명한다.
사용자가 직접 선택하는 처리 수준은 스탠더드, 하이, 맥스다. 일상적인 코딩부터 더 어려운 추론 작업까지 품질과 비용, 지연 시간 사이의 우선순위를 조정한다. 추가 검토가 붙는 캐스케이드와 크리틱은 단일 모델 실행보다 시간이 더 걸릴 수 있어, 모델을 많이 쓰는 방식이 항상 더 빠른 것은 아니다.
깃허브는 퓨전 맥스가 Artificial Analysis 코딩 에이전트 지수에서 60점을 기록했다고 밝혔다. 회사가 제시한 비교에서 이는 오퍼스 5.5 맥스를 사용한 클로드 코드와 2점 이내 차이였고, 작업당 평균 API 비용과 토큰 사용량은 약 절반, 소요 시간은 약 40% 적었다. 이 수치는 해당 평가 조건의 결과로, 모든 개발 작업이나 이용자의 실제 청구액이 같은 비율로 줄어든다는 의미는 아니다.
과금은 실행에 사용된 각 모델의 표준 요율을 따른다. 깃허브는 유료 코파일럿 요금제 이용자에게 퓨전 사용 시 모델 비용을 한시적으로 30% 할인한다고 안내했다. 벤치마크의 비용 절감 수치와 실제 서비스 할인율은 서로 다른 기준이다.
기업 관리자는 조직과 엔터프라이즈 정책으로 퓨전이 사용할 모델을 제한하고, 기본 처리 수준도 지정할 수 있다. 공식 문서에 따르면 퓨전은 모델을 고를 때 실시간 가용성과 시스템 상태도 고려한다. 모델 하나를 선택해 고정하는 방식에서, 허용된 모델 집합과 비용·품질 정책을 관리하는 방식으로 설정의 초점이 넓어진 셈이다.
퓨전은 비주얼 스튜디오 코드, 깃허브 코파일럿 앱과 CLI, 젯브레인즈 IDE에서 제공된다. 깃허브는 모든 코파일럿 요금제에서 이용할 수 있다고 밝혔지만, 공식 문서상 선택 가능한 처리 수준은 요금제별로 다르다. 기존 자동 선택이나 하이드라퓨전 연구 미리보기를 사용하던 설정은 대응하는 퓨전 처리 수준으로 전환된다.
출처: GitHub 공식 변경 로그 https://github.blog/changelog/2026-10-28-route-and-orchestrate-models-with-github-copilot-fusion
GitHub 공식 Copilot Fusion 문서 https://docs.github.com/en/copilot/concepts/models/copilot-fusion