가장 많이 본 클라우드·인프라 뉴스
추천 기사
MIT 한랩 공식 깃허브에 이볼빙 인프라(Evolving Infra)의 소스 코드와 배포 문서가 공개됐다. 연구진이 이달 12일 수정본을 올린 기술 보고서에 따르면, 이 시스템은 AI 에이전트가 맡는 작업의 구성이 바뀔 때 추론 서버의 연산 자원 배분도 함께 조정한다.
LLM 추론은 입력을 한꺼번에 처리하는 프리필(prefill)과 답변 토큰을 하나씩 생성하는 디코드(decode)로 나뉜다. 컴퓨터 조작 에이전트는 화면 이미지 등 긴 입력을 자주 처리하는 반면, 수학 에이전트는 풀이를 길게 생성하는 데 연산을 더 많이 쓸 수 있다. 작업이 바뀌어도 두 단계에 할당한 GPU 비율이 고정돼 있으면, 한쪽에서 요청이 밀릴 때 다른 쪽 자원은 놀 수 있다.
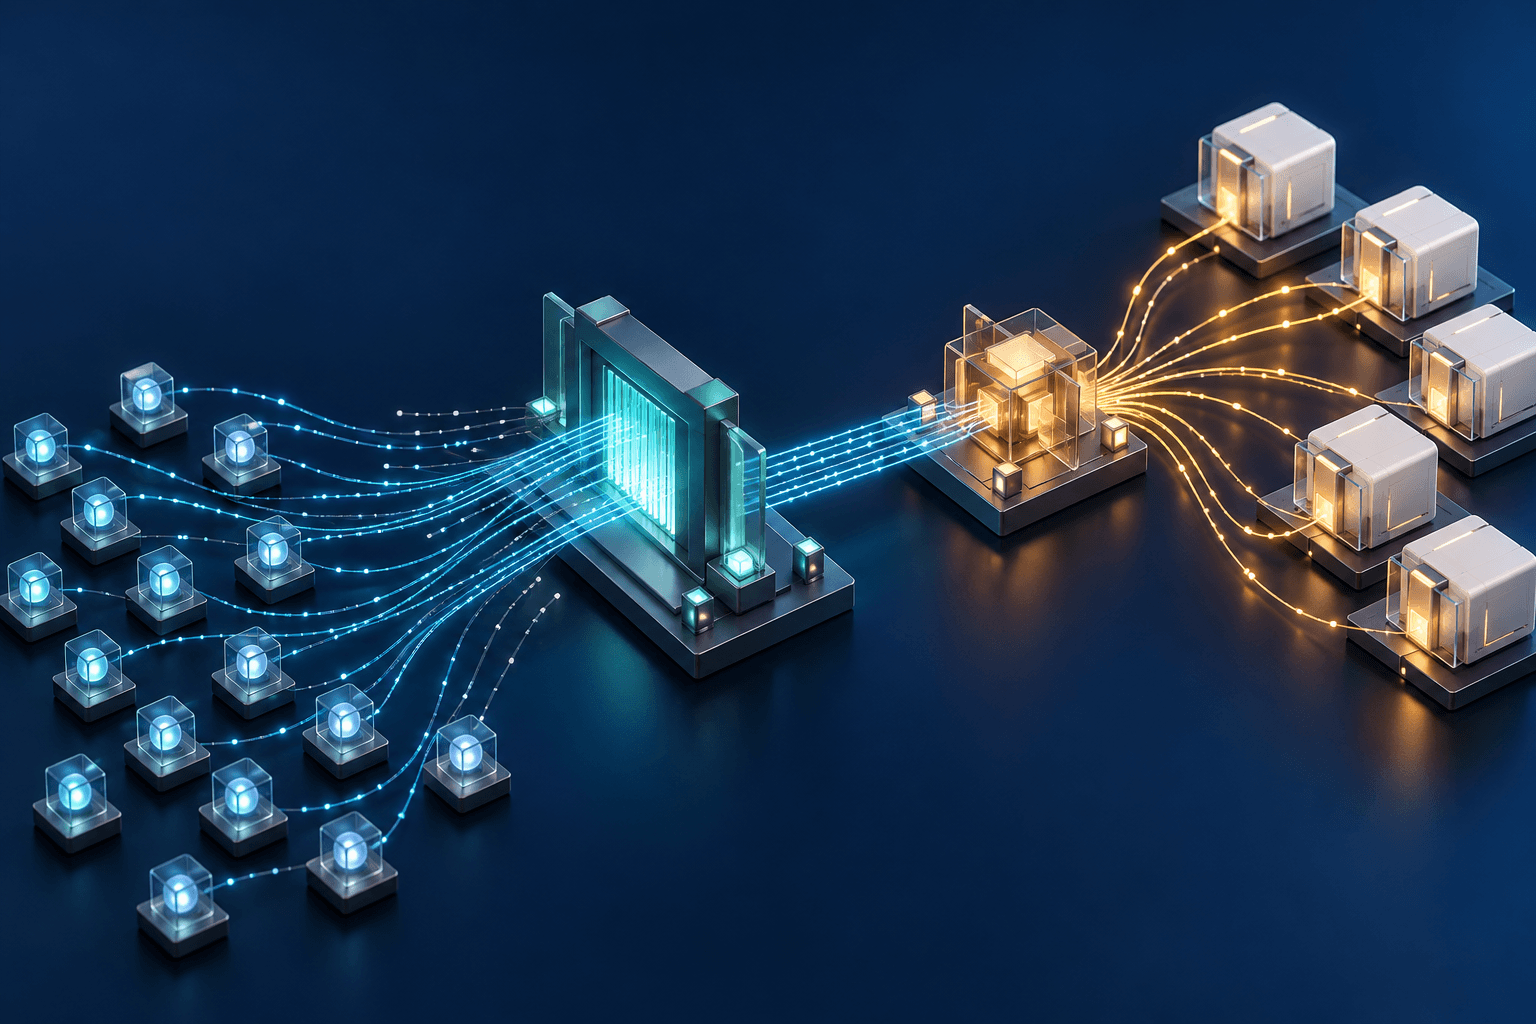
이볼빙 인프라는 요청을 처리하는 중에 단계별 연산 수요를 추정하고 GPU 노드의 역할을 재배치한다. 앞서 처리한 입력의 중간 계산값인 키·값(KV) 캐시는 노드의 역할과 분리해 공유한다. 덕분에 노드를 재시작하지 않고 역할을 바꿀 수 있고, 에이전트의 하위 작업이 끝나거나 대화 이력이 요약돼 더는 쓰이지 않는 캐시만 골라 비울 수 있다.
연구진은 엔비디아 GB300 GPU 36개에서 GLM-5.2와 키미 K2.6으로 코딩·수학·컴퓨터 조작 작업을 재현했다. 단일 유형의 작업을 일정한 부하로 실행한 실험에서 엔비디아 다이나모(Dynamo) 대비 평균 요청 처리 시간은 최선의 경우 약 4분의 1, 요청의 95%가 첫 토큰을 받기까지 걸린 시간은 최선의 경우 약 14분의 1이었다. 다만 동시 에이전트가 224개 또는 288개인 수학 작업에서는 처리량을 우선한 배치 때문에 첫 토큰 대기 시간의 95백분위 값이 오히려 길어졌다.
출처: MIT 한랩 공식 깃허브 https://github.com/mit-han-lab/EvolvingInfra · 이볼빙 인프라 공식 프로젝트 https://inference-rsi.com/ · 연구진 기술 보고서(arXiv) https://arxiv.org/abs/2611.12304