가장 많이 본 오픈소스 뉴스
추천 기사
Tiime Software가 AI 코딩 에이전트를 소프트웨어 테스트의 반례 탐색에 활용하는 ‘LLM Fuzz CI’를 공개했다. 개발사의 10월 5일 공식 발표와 GitHub 저장소에 따르면, 이 도구는 개발자가 지정한 테스트를 읽고 실패를 일으킬 입력을 만든 뒤 별도 실행 환경에서 재검증한다.
기존 퍼징이 예기치 않은 입력을 반복해 코드의 오류를 찾는 방식이라면, LLM Fuzz CI는 코딩 에이전트가 코드와 테스트의 의도를 읽고 입력 후보를 제안하도록 설계됐다. 버그 여부를 AI의 설명만으로 판단하지 않고, 개발자가 작성한 테스트 조건이 실제로 깨지는지를 확인하는 데 초점을 맞췄다.
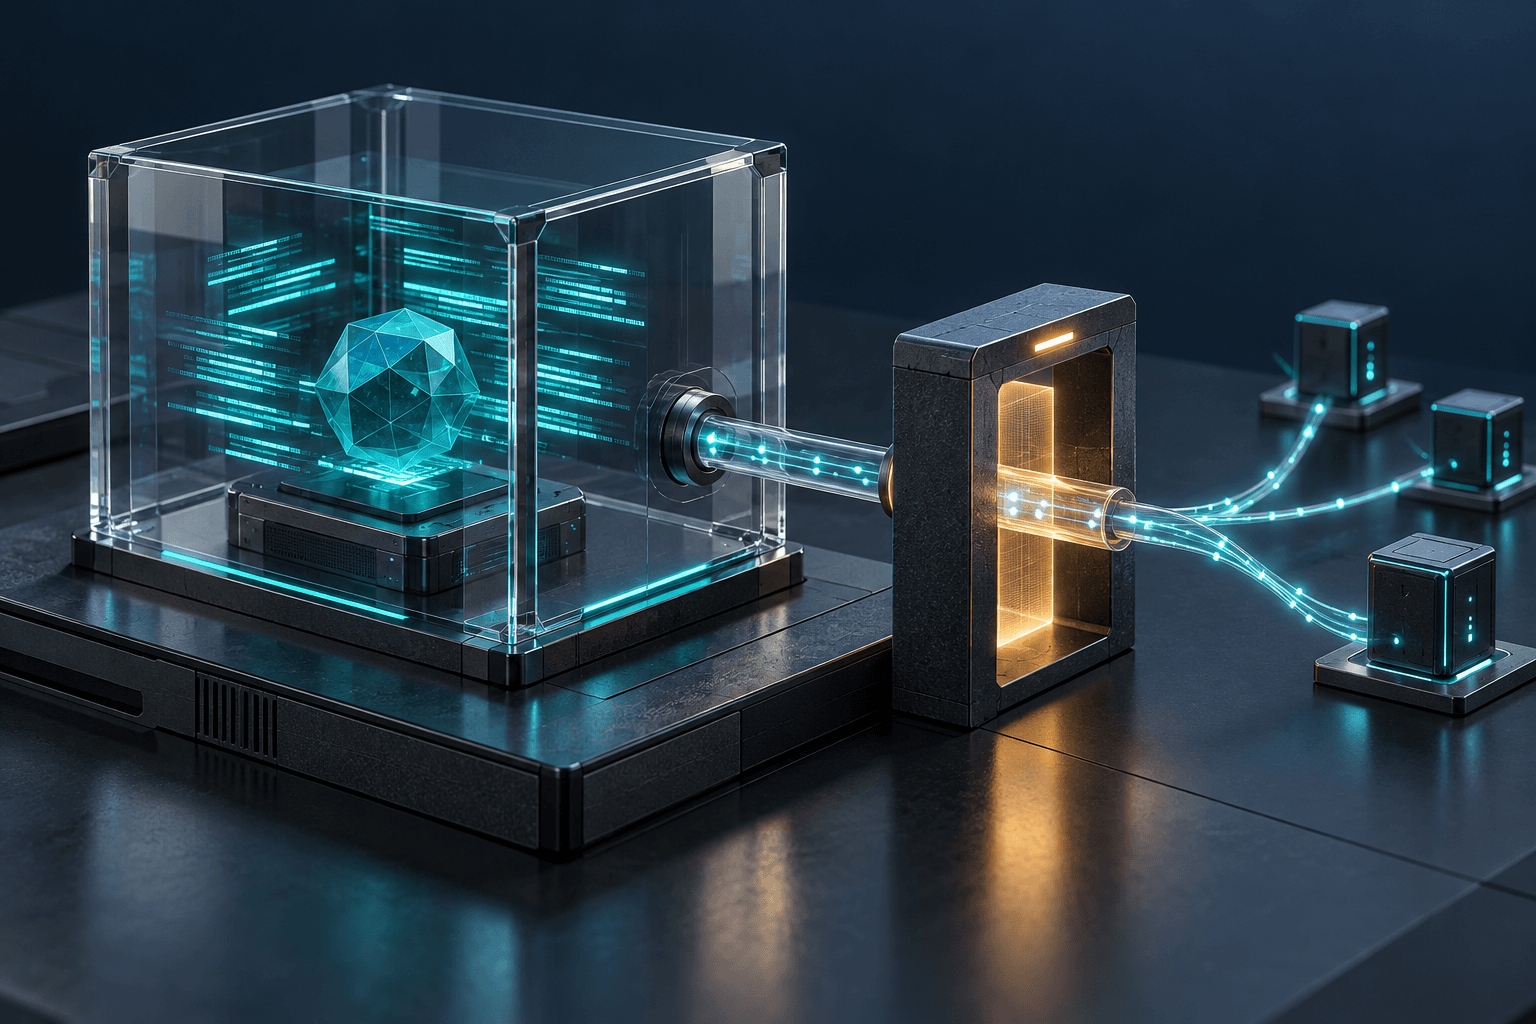
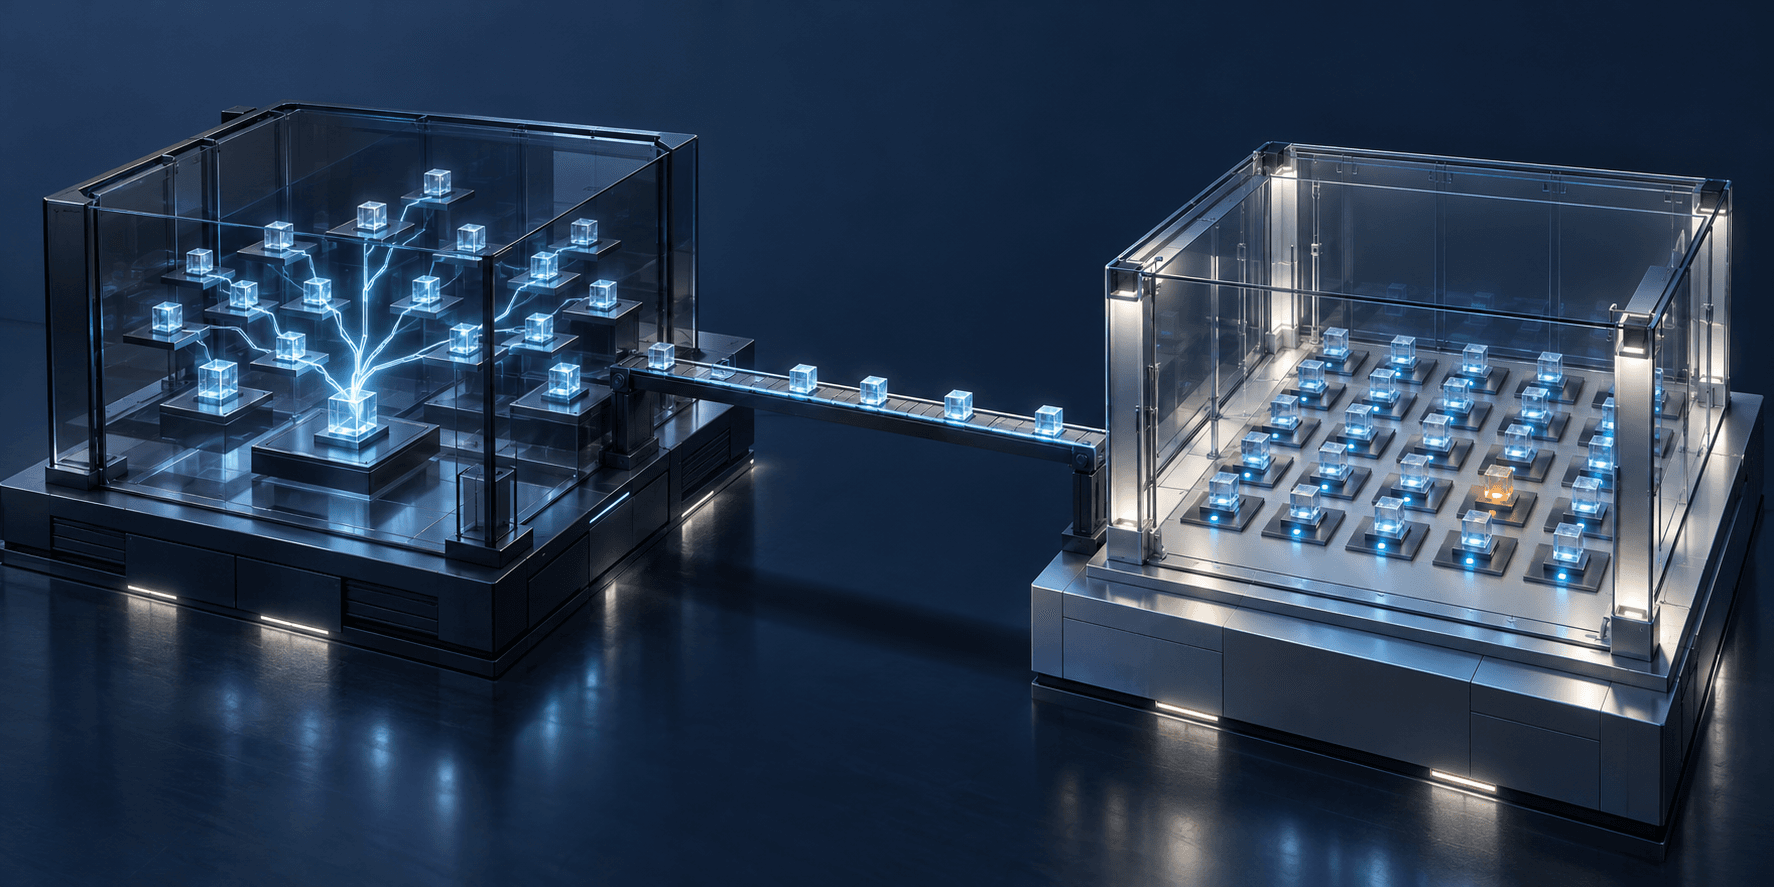
입력 생성과 검증은 두 단계로 나뉜다. 공식 GitHub Actions 예제에서는 첫 번째 작업이 코드를 읽고 입력을 수집한다. 두 번째 작업은 별도 러너에서 원본 코드를 다시 체크아웃한 뒤 전달받은 입력으로 테스트를 실행한다. 생성 단계에서 에이전트가 코드를 수정하더라도 그 변경을 검증 환경에 그대로 넘기지 않는 구조다.
지원 대상은 Python의 pytest와 JavaScript의 Vitest다. 개발자는 퍼징할 테스트를 표시하고 필요한 경우 입력 항목을 제한할 수 있다. 기본 입력 생성 도구는 Codex이며 Claude Code도 선택할 수 있다. 저장소는 MIT 라이선스로 공개됐다.
실행 결과에는 테스트별 상태, 실패 입력, 실패한 검증 조건을 담은 요약과 산출물이 남는다. 에이전트 실행 기록도 함께 보관한다. 옵션을 설정하면 GitHub 이슈를 만들거나 실패 입력이 재현됐을 때 CI 작업을 실패 처리할 수 있다.
이 방식에서도 테스트가 정의한 조건이 곧 검증 범위다. 작성되지 않은 요구사항이나 잘못된 테스트 자체까지 자동으로 검증하는 것은 아니다. 개발사 역시 어떤 대상을 검사하고 무엇을 확인할지 정하는 작업이 중요하다고 설명한다. AI의 오류 주장과 실제로 재현되는 테스트 실패를 구분하면서도, 검사 기준은 개발자가 설계해야 한다는 의미다.
출처: Tiime Software 공식 발표
https://tiime-software.github.io/blog/llm-fuzz-ci/
LLM Fuzz CI 공식 GitHub 저장소
https://github.com/Tiime-Software/llm-fuzz-ci
LLM Fuzz CI 공식 GitHub Actions 예제
https://github.com/Tiime-Software/llm-fuzz-ci/blob/main/templates/llm-fuzz-ci.yml